Deux jours au salon Big Data & AI N°4 : Bug report, ce n’était pas le LLM
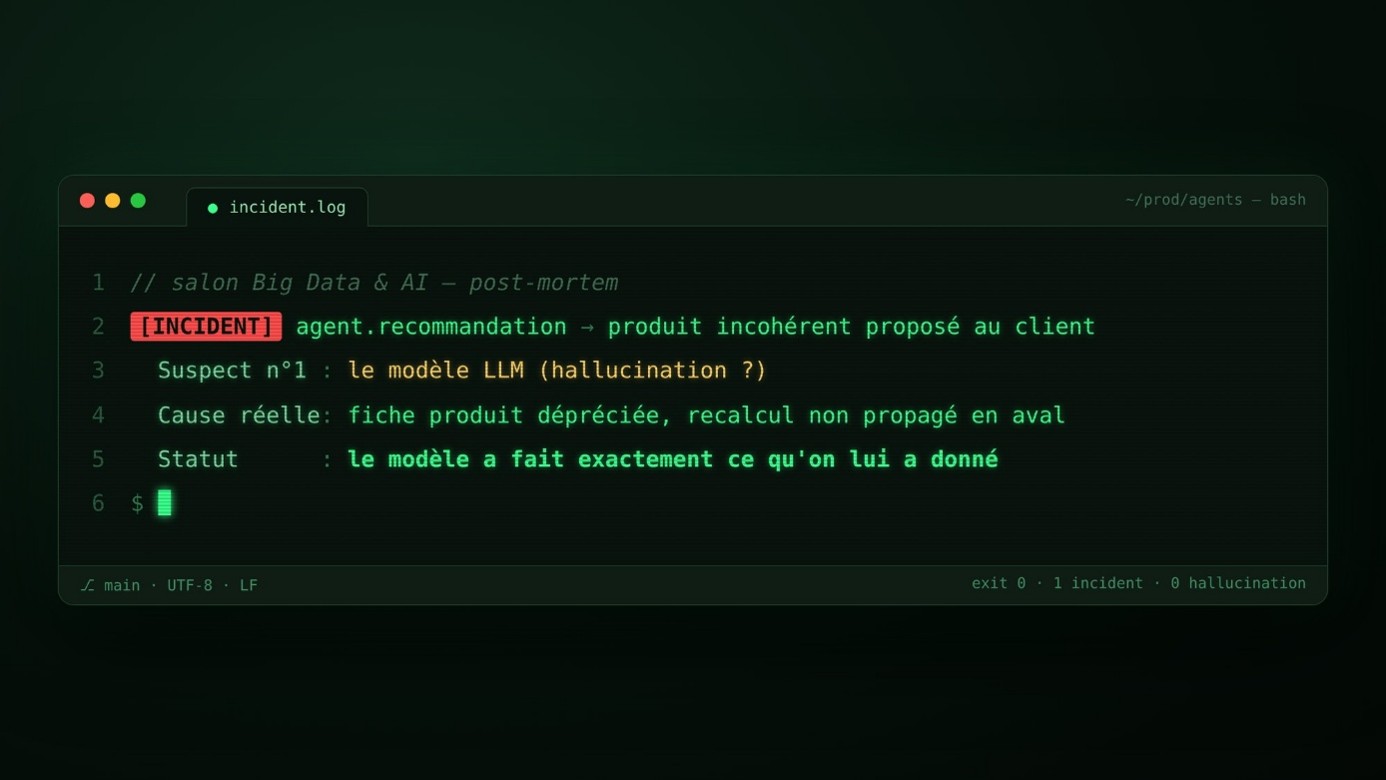
Cet incident a été raconté au salon Big Data & AI par une experte en gouvernance de la donnée du secteur du luxe. Il résume assez bien deux jours de conférences : quand une IA se trompe, le coupable est rarement le LLM. Il est presque toujours dans la chaîne. Spoiler : l'IA est un révélateur de problèmes plus traditionnels, multiples et de natures différentes, pouvant se cumuler. Car derrière l’emballement, les questions restent celles que l’on connaît : qualité des données, gouvernance, adoption, passage à l’échelle. Nous avons donc fait ce que fait tout ingénieur devant un bug : poser des points d’arrêt tout au long de la chaîne.
//Breakpoint #1 – Le flux : la donnée fraîche ou rien
Chez un avionneur, l’objectif est concret : produire des avions plus vite. Pour y parvenir, il construit un socle temps réel en architecture data mesh, avec des data products portés par les métiers, une plateforme en libre-service et une gouvernance fédérée. Côté technique : Kafka pour l’ingestion des données capteurs, Spark pour les calculs lourds, des fonctions serverless pour le traitement léger, Iceberg pour la persistance long terme, SQL pour l’exploration. La partie difficile n’est pas dans la liste des briques. Elle est dans la contextualisation et la synchronisation : gérer les décalages, les interruptions, les états intermédiaires. Prochaine étape annoncée sur sa feuille de route : brancher l’IA agentique sur ce flux. Un agent qui décide sur une donnée vieille de la veille reste un agent d’hier.
//Breakpoint #2 – Le socle : attention à la dette
Un opérateur de transport public a industrialisé son système de RAG sur une architecture en couches bronze → silver → gold, dont la dernière couche n’est plus une table mais une base vectorielle. Bien vu, aussi, la mutualisation des projets sur une même plateforme, qui fait baisser le coût d’infrastructure par besoin couvert. À l’inverse, un assureur partage le revers du décor : un datalake construit au fil des cas d’usage, qui compte aujourd’hui un nombre de tables hors norme.
Résultat : des doublons, une qualité de donnée mal connue, et une facture FinOps qui suit. La dette technique de la donnée existe, et l’IA en hérite.
//Breakpoint #3 – Le contexte : la métadonnée n’est pas un inventaire
Un éditeur de plateforme data cloud a résumé les quatre fondamentaux d’une plateforme agentique :
- Un stockage qui gère le structuré et le non structuré ;
- Une couche sémantique qui donne le sens métier ;
- Le contrôle d’accès, aux données comme aux modèles ;
- L’observabilité.
Son constat : si la fondation est en silos, aucun agent ne pourra couvrir toute la chaîne. Le message rejoint celui de notre experte du luxe : la métadonnée doit devenir une véritable couche de connaissance, avec glossaire métier, responsables identifiés et provenance, et pas un simple catalogue.
//Breakpoint #4 – Le LLM : choisir le plus frugal
Un groupe bancaire mutualiste l’assume : pour chaque tâche, il retient le LLM le plus frugal. Une traduction n’a pas besoin du modèle le plus puissant du marché. Le LLM devient un paramètre qu’on arbitre entre coût et performance, et qu’on doit pouvoir remplacer. Reste la question de l’hébergement. Une mutuelle d’assurance s’est tournée vers un opérateur qualifié SecNumCloud. L’opérateur de transport, aujourd’hui hébergé chez un hyperscaler américain, reconnaît que la question de la souveraineté se pose avant de passer à l’agentique.
//Breakpoint #5 – L’agent : définir son périmètre avant de le déployer
Le même groupe bancaire décrit le vrai défi des agents conversationnels à grande échelle : tenir ensemble robustesse, résilience, performance et durabilité, alors que les interactions se multiplient et que les agents se parlent entre eux. Sa méthode : pas de big bang, et repenser le processus dès l’origine plutôt qu’empiler des cas d’usage. Au passage, une partie des contrôles et validations disparaît. Une règle revient dans plusieurs interventions : définir précisément le champ de décision d’un agent avant de le lancer.
//Breakpoint #6 – L’humain : malgré tout au cœur de l’IA
Une mutuelle santé, partie de zéro en data en 2020, partage son kit de démarrage : un sponsor au comité de direction qui croit au projet, des RH embarquées, un product owner issu du métier, et des réussites prouvées vite et racontées en interne. Cette conférence portait bien son nom : « Construire une culture Data pour une adoption des métiers ». L’assureur rappelle de son côté que le data owner est un rôle en plus du métier d’origine, et que le retour sur investissement dépasse souvent un an.
Notre avis
Pendant des années, on a appris à tracer la provenance d’une table. L’IA prolonge la chaîne : elle consomme la donnée, l’enrichit, appelle des outils et déclenche des actions. L’unité à tracer n’est donc plus la table mais la décision, prise à un instant donné, dans un contexte précis, par un système dont quelqu’un doit répondre. Le lineage ne peut plus se contenter de décrire ce qui devrait se passer au moment de la conception. Il doit prouver ce qui s’est passé pendant l’exécution, en combinant trois éléments : la provenance, l’observabilité et la gouvernance. Des logs sans gouvernance, ce n’est que du bruit.
Conclusion : La prochaine fois qu’une IA se trompe, ne cherchez pas que le coupable : cherchez la décision.
Vous vous reconnaissez dans ces constats ? Chez Aessentia, nous accompagnons les entreprises sur leurs enjeux Data & IA, au-delà des discours. Parlons de votre contexte.